
Status 200. CPU w normie. Brak alarmu. Tymczasem klient czeka 20 sekund na przejście do koszyka. Nie zgłasza problemu. Po prostu zamyka kartę.
To kosztowny rodzaj problemu: system formalnie działa, ale po cichu obniża konwersję, wydłuża pracę albo zwiększa koszt infrastruktury. W raporcie widać skutek. W panelu technicznym przyczyna może nadal pozostawać niewidoczna.
Observability (obserwowalność systemu) to zdolność oceny jego rzeczywistego stanu na podstawie metryk, logów i trace’ów. Łączy to, co próbował zrobić użytkownik, z zachowaniem technologii i wynikiem biznesowym. Celem nie jest zbieranie wykresów. Celem jest odpowiedź na pytanie: czy technologia rzeczywiście dowozi proces biznesowy?
Co to jest observability i co daje biznesowi
Metryki biznesowe pokazują przychód, konwersję, liczbę zapytań. Jeśli technologia jest filarem sprzedaży albo operacji, jej kondycję trzeba mierzyć równie uważnie: dostępność, czas odpowiedzi, błędy, zapas zasobów.
Monitoring odpowiada na pytania zadane z góry: czy serwer działa, czy CPU przekroczyło próg. Observability wyjaśnia problem, którego nikt nie przewidział. Niskie użycie CPU nie potwierdza, że klient dostał wynik, a spadek konwersji sam nie mówi, czy zawiniła oferta, kampania czy aplikacja. Dlatego łączy trzy perspektywy:
- Wynik biznesowy: czy klient zakończył zakup, wysłał formularz albo otrzymał zakupiony dostęp?
- Doświadczenie użytkownika: ile czekał i na którym kroku zrezygnował?
- Stan technologii: która usługa, baza, kolejka lub integracja odpowiadała za problem?
Ma to znaczenie także wtedy, gdy system nadal działa. Ponowienia, cache i mechanizmy zapasowe maskują błędy: użytkownik jeszcze widzi wynik, ale w tle rośnie liczba wyjątków i kolejka zadań. Bez pomiaru problem zauważysz, gdy skończy się zapas.
Co monitorować na stronie, w sklepie i aplikacji
Nawet prosta strona zależy od hostingu, DNS, certyfikatu, CMS, formularzy i zewnętrznych skryptów. Aktualizacja jednej paczki może zepsuć funkcję, mimo że serwer odpowiada. Minimum to cztery testy:
- Dostępność: czy strona odpowiada z zewnątrz i ma poprawny certyfikat?
- Renderowanie: czy przeglądarka wyświetliła kluczową treść, a nie pusty ekran po błędzie JavaScript?
- Wydajność: jaki jest czas dla typowego użytkownika oraz dla najwolniejszych wizyt?
- Krytyczna ścieżka: czy można dodać produkt do koszyka, wysłać formularz, zalogować się?
Nie patrz na średnią. Mierz p50, p95, a przy większym ruchu także p99. Dla stron pomocnym punktem odniesienia są Core Web Vitals: LCP do 2,5 sekundy, INP do 200 ms i CLS do 0,1 na 75. percentylu wizyt.
Cztery realne przypadki, które teoretycznie działały
W każdym z nich system odpowiadał poprawnie, a ważna ścieżka nie działała.
1. Koszyk potrzebował ponad 20 sekund
Sklep był dostępny, a właściciel w ręcznych testach widział dobre czasy. Monitoring pokazał, że dla dużej części użytkowników przejście do koszyka trwało ponad 20 sekund. Nikt tego nie zgłaszał. Klienci po prostu rezygnowali. Dopiero p95, trace (ślad przebiegu operacji) i logi pokazały skalę i wolny etap żądania.
Wniosek: nie wystarczy sprawdzać, czy usługa jest online. Trzeba mierzyć, czy ścieżki krytyczne mieszczą się w akceptowalnym czasie.
2. Nie tylko programiści potrzebują snu
W zwykłych testach serwis działał. Historia dostępności pokazała, że co kilka dni w nocy przestawał odpowiadać, bo współdzielony hosting nie radził sobie z obciążeniem. Bez pomiaru przez całą dobę wyglądało to na chwilowy kłopot z internetem.
Wniosek: test w południe nie opisuje całej doby. Historia dostępności odróżnia incydent od powtarzalnego ograniczenia infrastruktury.
3. Testy na części danych, ale nie na pełnej skali
Aktualizację aplikacji liczącej na dużych zbiorach przetestowano na próbce danych. Testy przeszły. Nikt nie zauważył, że podczas obliczeń aplikacja zużywała ponad 90% dostępnych zasobów. Bez metryk pamięci wyciek wyszedł dopiero przy pierwszym przetwarzaniu pełnego zbioru na produkcji.
Wniosek: test funkcjonalny odpowiada na pytanie „czy działa”. Dopiero metryki zasobów odpowiadają na pytanie „jak długo jeszcze będzie działać”.
4. Kampania wygenerowała ruch, na który system nie był gotowy
Zespół reklamy nie uprzedził o wydarzeniu, które wygenerowało skok ruchu. Szczyt przeciążył stronę i kolejne elementy infrastruktury. Komunikacja pozwoliłaby przygotować cache i skalowanie, ale monitoring powinien być drugą linią obrony: rosnąca liczba żądań, opóźnienia i długość kolejek ostrzegają przed pełną awarią.
Wniosek: observability nie zastępuje komunikacji, ale ogranicza koszt jej braku.
Jakie metryki monitorować
| Obszar | Co mierzyć | Pytanie biznesowe |
|---|---|---|
| Krytyczny proces | skuteczność i czas zakupu, formularza, logowania lub kalkulacji | Czy klient może osiągnąć cel? |
| Dostępność | odpowiedź HTTP, renderowanie, test syntetyczny | Czy produkt jest dostępny przez całą dobę? |
| Wydajność | p50, p95, p99 dla strony, API i zadań | Jak długo czekają użytkownicy? |
| Błędy | wyjątki, timeouty, nieudane płatności | Jak często proces się nie kończy? |
| Zasoby | CPU, pamięć, dysk, połączenia DB, kolejki | Jak blisko system jest limitu? |
| Zależności | czas i błędy API płatności, poczty i dostawców | Czy problem jest poza naszym kodem? |
| Wdrożenia | wersja, czas publikacji, zmiana błędów i opóźnień | Czy nowa wersja pogorszyła działanie? |
| Koszt technologii | koszt dzienny i miesięczny, prognoza, koszt pojedynczej operacji | Czy wydatki rosną razem z wartością dla biznesu? |
Metryka ma prowadzić do decyzji. Jeżeli wykres rośnie, ale nikt nie wie, co oznacza i kto ma zareagować, jest dekoracją.
Monitorowanie kosztów chmury
Koszt infrastruktury też jest metryką. W modelu pay-as-you-go zapętlone zadanie, nadmiar logów albo zapomniane środowisko zwiększają fakturę bez żadnej wartości. Monitoruj bieżące wydatki, prognozę na koniec miesiąca i koszt jednej operacji: zamówienia, raportu, aktywnego klienta. Alarm ma przyjść przy nietypowym wzroście, nie po rachunku. O porządkowaniu tych kosztów piszemy w artykule o budżetowaniu technologii w MŚP.
Logi pokazują problemy, które system jeszcze ukrywa
System może wykonywać zadania i jednocześnie generować setki błędów. Ponowienia ukrywają awarię integracji, kolejka rośnie, pula połączeń jest prawie pełna, a pojedynczy test nadal przechodzi. To sygnały, które pozwalają zareagować przed awarią, utratą danych albo spadkiem sprzedaży.
Użyteczny log powinien zawierać czas, usługę, środowisko, wersję aplikacji, wynik operacji oraz trace_id lub request_id. Nie powinien zawierać haseł, tokenów ani niepotrzebnych danych klientów. Logi trzeba centralizować, ponieważ zapis na niedziałającym serwerze może zniknąć razem z nim.
Cloudflare, Sentry, SigNoz i Grafana: różne warstwy obserwacji
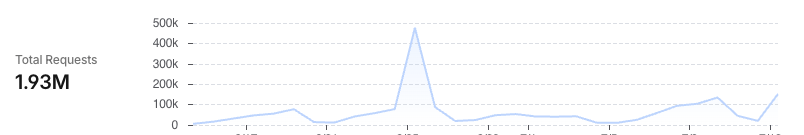
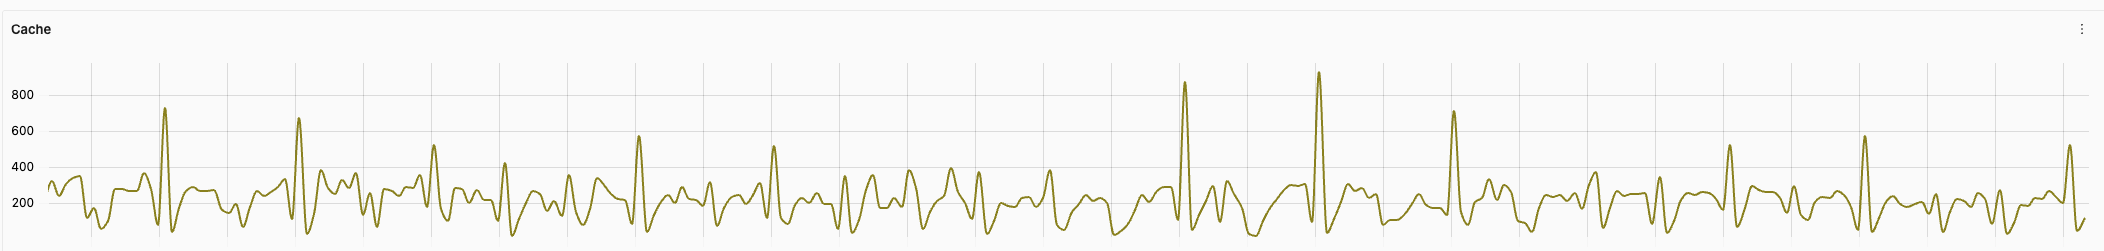
- Cloudflare nawet w bezpłatnym planie daje podstawowy obraz ruchu: liczbę żądań, transfer, unikalnych odwiedzających, kraje źródłowe i dane pomagające ocenić wykorzystanie cache. Security Analytics pozwala analizować podejrzany ruch, a automatyczna ochrona DDoS jest dostępna we wszystkich planach.
- Sentry porządkuje błędy, pokazuje stack trace, wersję, środowisko i liczbę dotkniętych użytkowników.
- SigNoz łączy metryki, logi, trace’y i alerty w platformie opartej na OpenTelemetry.
- Grafana tworzy wspólny widok danych z wielu źródeł i obsługuje reguły alarmowe.
Cloudflare pokazuje, co dzieje się na brzegu sieci: jaka jest skala ruchu, ile żądań obsłużył cache i czy pojawiają się wzorce przypominające atak. Nie pokaże jednak, czy po odpowiedzi 200 zamówienie zostało poprawnie zapisane albo dlaczego kalkulator zwrócił błędny wynik. Dlatego uzupełnia, ale nie zastępuje monitoringu krytycznego procesu, logów aplikacji i trace’ów.
Narzędzie jest wtórne wobec pytania. Mała strona potrzebuje kontroli dostępności, renderowania, formularza i wydajności. Sklep monitoruje całą ścieżkę zakupu. System biznesowy dodatkowo API, integracje, zadania w tle i bazę. Jeśli firma nie ma własnego zespołu operacyjnego, monitoring powinien być częścią utrzymania systemu, z przypisaną odpowiedzialnością za alerty.
AI w monitoringu: mniej szukania, szybsza reakcja
Przy większym systemie problemem nie jest brak danych, tylko ich nadmiar. Jedna awaria generuje tysiące logów i kilka alarmów z różnych usług. AI skraca ustalanie, co jest jednym incydentem, w czterech obszarach:
- Grupowanie: łączy podobne wyjątki, logi i trace’y w jeden incydent, zamiast wysyłać tysiące powiadomień.
- Priorytetyzacja: ocenia wpływ na krytyczny proces, liczbę użytkowników, transakcje i brak ścieżki zapasowej.
- Kontekst dla programisty: wskazuje aktywną wersję, powiązane logi, wolny fragment trace’a, zmianę po wdrożeniu i prawdopodobny punkt startowy analizy.
- Detekcja anomalii: porównuje aktualne zachowanie z historycznym wzorcem i wykrywa odchylenia bez ręcznego ustalania jednego progu.
Przykład użytecznej informacji dla programisty: „Po wdrożeniu 2.4.1 czas p95 koszyka wzrósł z 800 ms do 6,4 s. Większość czasu zajmuje nowe wywołanie API magazynu. Problem dotyczy 21% sesji mobilnych”. Programista dostaje hipotezę opartą na danych, a nie kolejny panel do przeszukania.
Żeby połączyć incydent z wdrożeniem, pipeline musi przekazywać numer wersji, commit, czas publikacji i środowisko. Wtedy da się porównać błędy i opóźnienia przed publikacją i po niej, a przy dojrzałym procesie zatrzymać wdrożenie albo zarekomendować wycofanie wersji.
AI nie zastępuje dobrych danych ani decyzji człowieka. Bez uporządkowanych logów, identyfikatorów trace i zdefiniowanej ścieżki biznesowej wygeneruje tylko przypuszczenie. Dostęp do kodu i logów musi też uwzględniać maskowanie danych i uprawnienia.
Alarm ma prowadzić do działania
Dashboard nie uruchomi reakcji. Najważniejsze sygnały potrzebują alarmu z warunkiem, pilnością, właścicielem i pierwszym krokiem diagnostycznym. Alarm na pojedynczy błąd tworzy hałas. Alarm na rosnący odsetek nieudanych płatności pokazuje wpływ. Dobra wiadomość odpowiada na trzy pytania: co się dzieje, kogo dotyczy i gdzie zacząć.
Metryki pokazują efekt wdrożenia
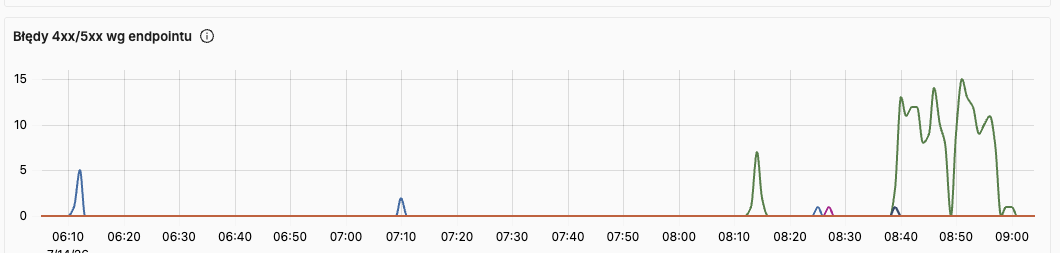
Każde wdrożenie powinno być widoczne na wykresach z numerem wersji i czasem publikacji. Zakończone wdrożenie nie znaczy, że system działa lepiej. Porównaj stan przed i po: p95, odsetek błędów, skuteczność krytycznego procesu, zużycie zasobów, koszt. Jeśli po publikacji rośnie p95 albo liczba błędów 4xx/5xx, to regresja i zespół może wycofać wersję, zanim zgłoszą to użytkownicy.
Poniższy wykres pokazuje bezwzględną liczbę błędów. Obok niej śledź udział błędów we wszystkich żądaniach: pięć błędów przy pięciu żądaniach to 100%, pięć przy 10 000 to 0,05%. Liczba pokazuje wolumen, procent skalę wpływu.
Checklista observability dla biznesu i IT
Zanim wybierzesz narzędzie, uzgodnij z zespołem, jaki wynik ma osiągnąć klient i po czym poznacie, że technologia przestała go wspierać.
Biznes: ustal cel i odpowiedzialność
- Krytyczny proces: wybierz zakup, formularz, kalkulację, logowanie albo integrację, której przerwanie kosztuje sprzedaż, czas lub zaufanie.
- Definicja sukcesu: nazwij wynik kończący proces, na przykład opłacone zamówienie lub poprawnie wysłane dane.
- Akceptowalny czas: określ, ile klient może czekać i kiedy spowolnienie zaczyna obniżać konwersję lub produktywność.
- Wpływ i priorytet: oszacuj koszt godziny problemu oraz wskaż zdarzenia wymagające natychmiastowej reakcji.
- Właściciel reakcji: przypisz osobę lub rolę odpowiedzialną za decyzję, komunikację i eskalację.
- Koszt technologii: monitoruj budżet chmury, prognozę rachunku i koszt pojedynczej operacji, klienta lub transakcji.
Technologia: zbierz sygnały potrzebne do decyzji
- Dostępność procesu: test z zewnątrz powinien wykonywać krytyczną ścieżkę, a nie tylko sprawdzać status HTTP.
- Czasy
p50,p95ip99: pokazują doświadczenie typowego użytkownika i najwolniejsze przypadki, które ukrywa średnia. - Udział błędów: obserwuj jednocześnie liczbę błędów i ich procent we wszystkich żądaniach.
- Zasoby i zależności: połącz CPU, pamięć, bazę, kolejki oraz zewnętrzne API z konkretnym procesem biznesowym.
- Logi i trace: centralizuj dane, dodaj
request_idlubtrace_id, wersję aplikacji i wyklucz sekrety. - Wdrożenia: oznaczaj na wykresach czas publikacji, wersję i commit, aby porównać stan przed zmianą i po niej.
- Alerty i runbook: każdy ważny alarm powinien mieć próg, właściciela, kanał eskalacji i pierwszy krok diagnostyczny.
- Koszty i anomalie: alarmuj o nietypowym wzroście rachunku, ruchu, logów albo kosztu pojedynczej operacji.
Technologia ma dowozić wynik, nie tylko działać
Zielony serwer nie jest celem. Celem jest klient, który może kupić, wysłać dane lub wykonać swoją pracę. Observability pokazuje moment, w którym technologia przestaje ten cel wspierać, i daje czas na reakcję, zanim problem stanie się reklamacją albo awarią.